Ce qu'implique réellement le déploiement à grande échelle de plateformes de gestion scientifique
L'implémentation d'un logiciel de gestion de laboratoire à l'échelle de l'entreprise ne se résume pas au choix de la bonne plateforme. Voici les autres facteurs dont dépend votre réussite.
Download Whitepaper
Ready to see SciSure in action?
No commitment · Free consultation
J'ai travaillé en laboratoire. Je sais ce qu'il en est quand les systèmes ne communiquent pas entre eux, quand tout tombe en panne sans raison apparente, et quand vous passez la moitié de votre après-midi à répéter la même tâche manuelle que la veille. Ces dernières années, j'ai mis en place des plateformes de gestion scientifique (dont SciSure) dans des environnements allant des instituts de recherche sur le cancer à des déploiements universitaires comptant des milliers d'utilisateurs.
Ayant été chercheur, responsable du soutien à la recherche, fournisseur de logiciels et analyste métier en entreprise, j'ai appris que la réussite d'une transformation numérique est rarement limitée par la technologie. Elle est limitée par la capacité d'une organisation à traduire la technologie en méthodes de travail reproductibles.
Dans cet article, je vais vous montrer à quoi ressemble une implémentation à l'échelle de l'entreprise en réalité : qui doit être présent, ce qu'implique un calendrier réaliste, et pourquoi un plan de gestion du changement n'est pas facultatif. Si vous êtes responsable des opérations de laboratoire, responsable informatique de recherche ou analyste métier chargé de numériser un environnement scientifique complexe, cet article est pour vous.
Pourquoi les implémentations de logiciels de laboratoire en entreprise échouent-elles ?
Les déploiements de logiciels de laboratoire à l'échelle de l'entreprise peinent souvent parce que l'ampleur du changement organisationnel est sous-estimée dès le départ. Je n'ai pas encore rencontré de commanditaire de projet qui propose avec enthousiasme de consacrer le temps de ses collaborateurs aux six prochains mois de migration de trente ans de feuilles de calcul et à la formation de milliers d'utilisateurs.
C'est dans cet écart entre l'ambition organisationnelle et l'engagement organisationnel que l'implémentation commence à échouer. Si vous voulez comprendre l'ensemble du tableau de pourquoi l'adoption des ELN et LIMS échoue au niveau de l'entreprise, cela revient souvent à ceci.
Passer de « nous en avons besoin » à « nous allons faire en sorte que cela fonctionne » exige quelque chose pour lequel la plupart des entreprises hésitent à allouer un budget : une équipe projet dédiée. Pas seulement un chef de projet avec dix autres responsabilités, mais une véritable équipe avec des rôles clairement définis et le temps nécessaire pour agir.
Qui doit être impliqué avant même l'installation du logiciel
Sponsors exécutifs : ceux qui signent et restent impliqués
La validation par la direction envoie un signal fort au reste de l'organisation : cette initiative est prise au sérieux. Mais trop souvent, la direction signe le contrat et disparaît. Les déploiements à l'échelle de l'entreprise nécessitent un sponsor exécutif qui reste visible tout au long du processus, quelqu'un qui communique aux groupes de recherche que la participation n'est pas facultative, ou à tout le moins, fortement recommandée. Ce message a beaucoup plus de poids lorsque le sponsor peut démontrer qu'une équipe projet dédiée est là pour accompagner les utilisateurs durant la transition.
Un analyste métier qui comprend le laboratoire
Avant qu'un fournisseur ne puisse présenter une démonstration, un analyste métier doit cartographier l'état actuel: comment les échantillons sont stockés, comment les chercheurs les trouvent, quelles réglementations s'appliquent, et sur quels éléments un système performant vous permettrait de faire des rapports que vous ne pouvez pas générer aujourd'hui. Cette analyse de l'état actuel est ce qui produit le document des exigences, et au niveau de l'entreprise, nous parlons de centaines d'exigences, classées par priorité.
Ce rôle est souvent sous-estimé. Au-delà de la simple documentation des processus, il s'agit également de traduire le besoin du chercheur (« Je veux trouver mon échantillon d'ADN sans chercher dans trois feuilles de calcul ») en une structure de gouvernance (« les modèles de types d'échantillons doivent être standardisés dans tous les groupes et verrouillés contre toute modification non contrôlée »). Ces deux aspects sont liés, mais ils nécessitent des conversations très différentes avec des interlocuteurs très différents.
Avec une plateforme comme SciSure, ce processus de traduction comporte de véritables enjeux techniques.
La plateforme de gestion scientifique de SciSure prend en charge la documentation des expériences, la gestion des échantillons, ainsi que la normalisation des protocoles, couvrant la documentation de recherche via le cahier de laboratoire électronique (ELN) et l'inventaire via la gestion des échantillons et du stockage.
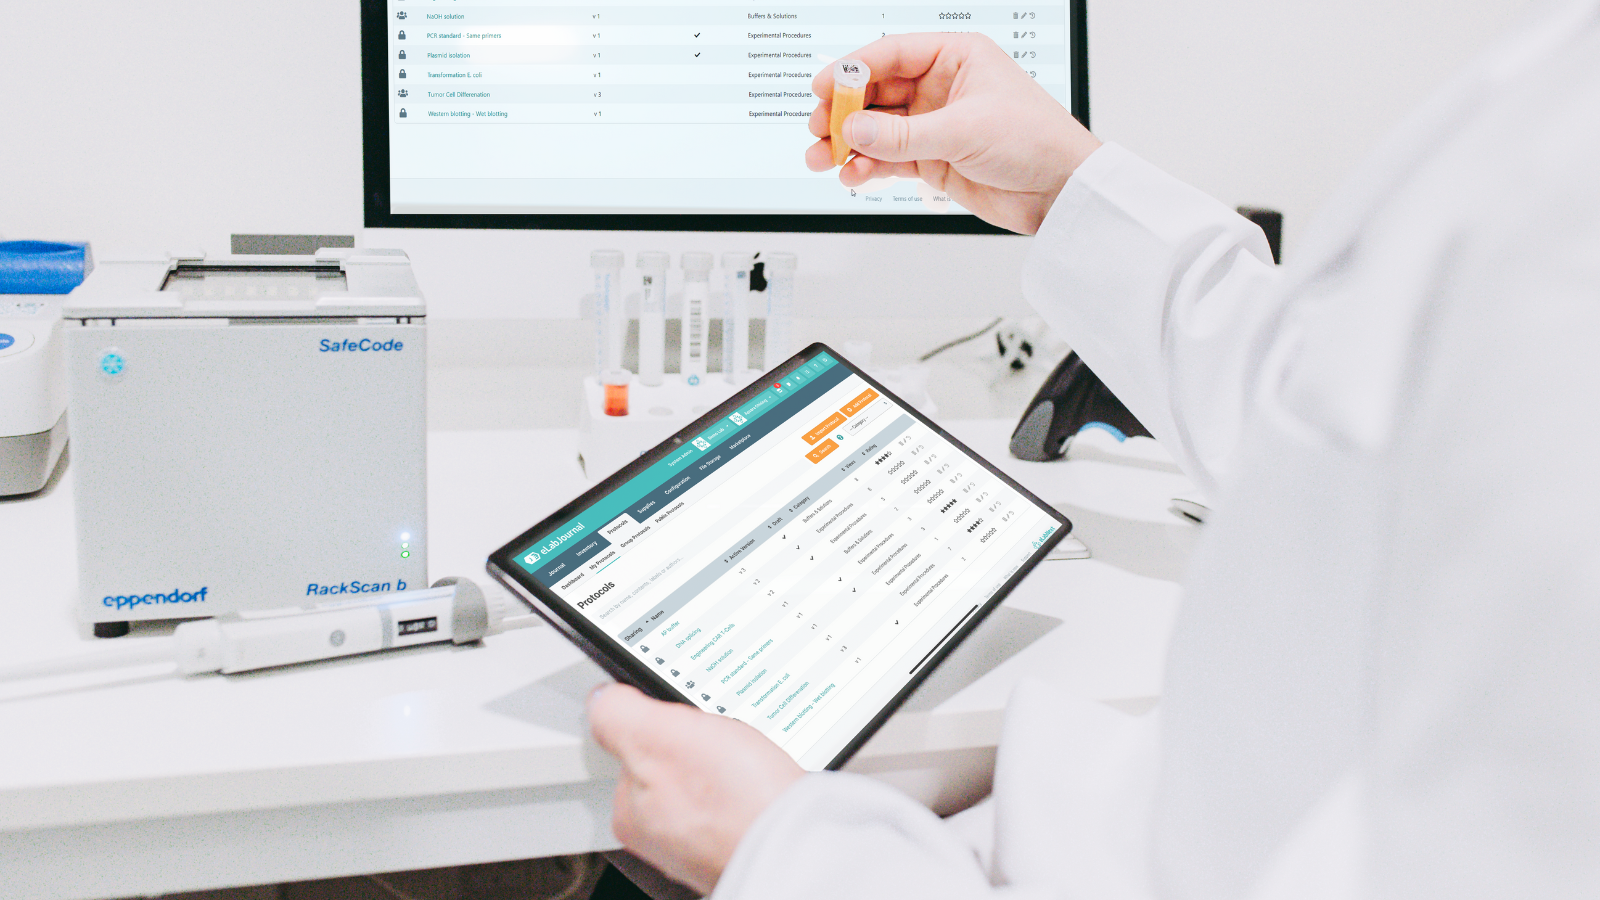
L'analyste métier doit déterminer quels modules sont concernés, comment ils interagissent et quelle normalisation des données est requise avant la mise en service pour le premier utilisateur. Les fonctionnalités et les flux de travail varient selon les modules sous licence et la configuration du système ; cette phase de définition du périmètre doit donc intervenir très tôt.
Un groupe d'utilisateurs clés représentatif de l'organisation
Lors d'un déploiement dans une grande université, nous avons constitué un groupe d'utilisateurs clés composé de 36 à 40 personnes : responsables d'installations, chercheurs, directeurs de recherche et personnel issu de différentes écoles et instituts. Ce groupe a pris des décisions de configuration, comme l'obligation d'apposer une signature sur chaque expérience ou la nomenclature des unités de stockage. Leurs décisions ont été documentées et le système a été configuré en conséquence.
Sans un groupe représentatif pour trancher ces questions, vous finissez avec un administrateur système (souvent une seule personne) qui prend des décisions arbitraires que 5 000 utilisateurs suivront ou ignoreront discrètement.
Ceci est particulièrement important sur une plateforme comme SciSure, où le système est délibérément conçu pour être configuré par organisation, groupe et rôle. L'accès est régi par un modèle d'autorisations géré au niveau de l'administrateur de groupe, de l'organisation ou du système. Ce qu'un groupe peut voir et modifier diffère de ce qu'un autre groupe peut faire. Ces limites doivent être définies intentionnellement, documentées et verrouillées avant le déploiement. Le groupe d'utilisateurs clés est celui qui prend ces décisions.
Un support informatique doté des compétences adéquates
La migration de données à grande échelle n'est pas un travail pour une seule personne, et ce n'est pas une tâche que l'on peut confier à un chercheur ayant un après-midi de libre. Une migration propre nécessite quelqu'un capable de créer des outils. Dans notre cas, cela signifiait une macro Excel personnalisée capable de prendre des données d'échantillons désordonnées et aux formats mixtes pour les exporter dans la structure d'importation correcte. Cette capacité doit être définie et dotée de ressources avant le début du déploiement, et non découverte comme manquante en cours de route.
Au-delà de la migration, vous avez besoin d'une expertise informatique pour la configuration de l'authentification unique (SSO), la conformité en cybersécurité et les décisions d'intégration concernant les systèmes qui se chevauchent. Avec SciSure, cela implique également de réfléchir aux choix du modèle de déploiement. SciSure prend en charge le cloud public, le cloud privé, le déploiement sur site et un modèle de stockage hybride où la plateforme s'exécute dans le cloud tandis que les fichiers volumineux sont stockés sur un serveur local géré par le client, selon le déploiement. Chaque option a des implications différentes en matière d'infrastructure et de sécurité que l'équipe informatique doit évaluer avant la finalisation de l'achat.
La gouvernance ne commence pas au lancement
L'une des plus grandes idées reçues sur les implémentations de logiciels d'entreprise est que la gouvernance commence une fois le système mis en service. En réalité, la gouvernance commence bien plus tôt.
Avant même qu'un seul chercheur ne se connecte, les organisations doivent s'accorder sur les conventions de nommage, les structures organisationnelles, les normes de types d'échantillons, les rôles des utilisateurs, la propriété des modèles, les processus de contrôle des changements et les circuits de décision. Ces décisions déterminent si la plateforme restera cohérente à mesure que son adoption se développe.
Sans une gouvernance convenue du système numérique, les organisations ne se retrouvent pas seulement avec des données incohérentes. Elles se retrouvent avec des méthodes de travail incohérentes.
Différents groupes créent leurs propres normes, les rapports deviennent peu fiables et chaque changement futur devient plus difficile à mettre en œuvre. Ces incohérences rarement ne deviennent visibles immédiatement, mais ils s'accumulent avec le temps, rendant le reporting, la collaboration et les futures modifications du système de plus en plus complexes.
Le logiciel offre la fonctionnalité. La gouvernance détermine si cette fonctionnalité reste cohérente, fiable et évolutive au fil du temps.
D'après mon expérience au sein d'instituts de recherche, d'universités et de déploiements de logiciels scientifiques en entreprise, la gouvernance est systématiquement devenue le socle de chaque activité ultérieure, de la standardisation des types d'échantillons et des structures organisationnelles à la formation, au séquençage du déploiement et à la transition vers le mode opérationnel courant (BAU). Une fois ces décisions de gouvernance établies, le déploiement est devenu beaucoup plus facile à mettre à l'échelle, car chaque nouveau groupe de recherche, laboratoire ou unité organisationnelle pouvait être intégré en utilisant le même modèle opérationnel convenu.
À quoi ressemble un calendrier de déploiement réaliste en entreprise
Phase 1 : Besoins et approvisionnement (généralement de 3 à 12 mois)
Le processus d'approvisionnement à l'échelle de l'entreprise n'est pas une simple formalité. Dans les institutions soumises à des exigences d'appel d'offres formelles, cette phase implique la production d'un dossier d'appel d'offres (comprenant les documents relatifs aux besoins, les questionnaires de cybersécurité et les projets de contrat), puis son envoi à plusieurs fournisseurs par vagues successives. Vous en évaluez un grand nombre, en sélectionnez quelques-uns, puis envoyez le dossier complet aux finalistes.
Cette phase peut à elle seule prendre six mois à un an dans les organisations fortement régies par des processus de gouvernance. Intégrez cela dans votre planification. Avant d'émettre un dossier d'appel d'offres complet, utilisez notre guide des alternatives à Benchling pour les laboratoires d'entreprise pour vérifier si chaque plateforme correspond à votre modèle opérationnel.
Phase 2 : Recette utilisateur (2 à 3 mois)
Avant qu'un seul utilisateur ne soit opérationnel, vous devez vérifier que le système remplit réellement les fonctions prévues dans le cahier des charges. La recette utilisateur consiste à rédiger des cas de test détaillés, des instructions étape par étape pour chaque flux de travail principal, et à recruter des volontaires dans toute l'organisation pour les exécuter. L'objectif est de faire ressortir les éventuelles lacunes du système afin de les résoudre ou de prendre une décision éclairée pour poursuivre malgré tout.
Si le système échoue à des tests critiques, vous avez besoin d'une clause de sortie contractuelle. Assurez-vous qu'elle figure dans l'accord.
Phase 3 : Conception et configuration du système
Une fois les tests d'acceptation utilisateur (UAT) validés, vous passez à la phase de conception. C'est ici que le groupe d'utilisateurs clés joue tout son rôle. Les décisions de configuration sont prises, documentées et verrouillées, dans la mesure où le système le permet. Le système est alors paramétré selon votre structure organisationnelle, vos modèles de types d'échantillons, votre hiérarchie de stockage et votre modèle d'accès utilisateur.
Avec SciSure, cette phase est également celle où vous travaillez sur la configuration spécifique aux modules.
- La gestion des échantillons et des stocks de SciSure nécessite que votre hiérarchie d'unités de stockage et vos modèles de types d'échantillons soient finalisés.
- La bibliothèque de protocoles de SciSure nécessite que vos procédures opérationnelles normalisées (SOP) soient chargées et standardisées avant que les groupes ne commencent à s'en écarter.
- Si vous activez les inspections, la gestion des déchets ou le suivi des formations, ces flux de travail doivent être configurés avant que les utilisateurs ne les rencontrent sur le terrain.
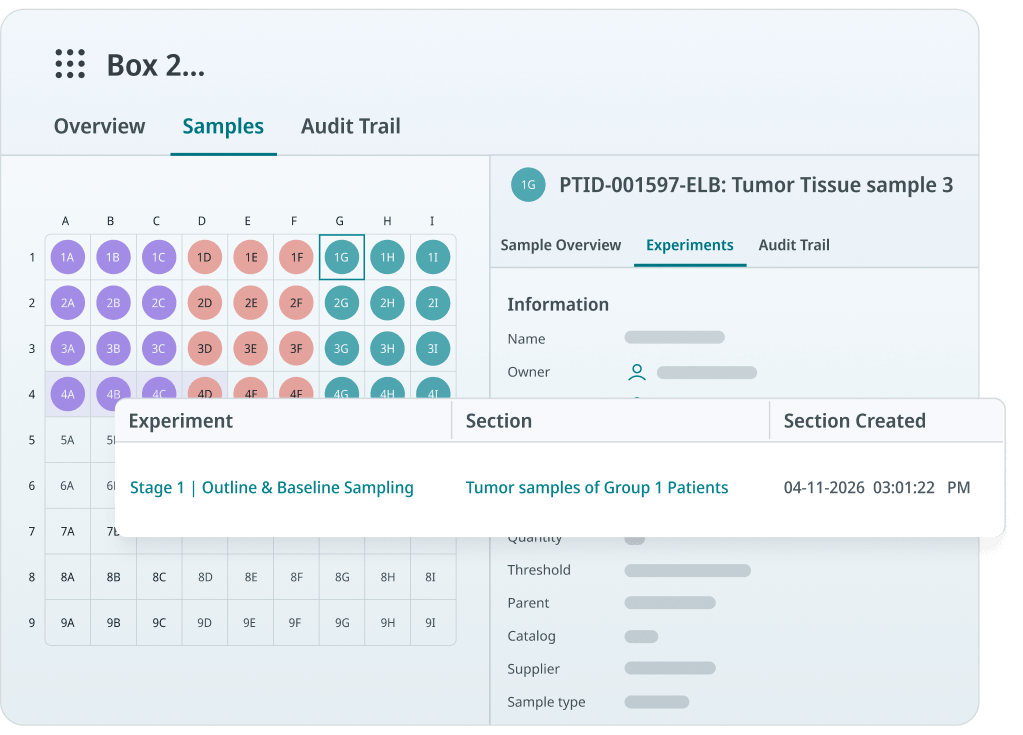
Certaines de ces fonctionnalités varient selon le module et le déploiement ; il est donc judicieux de confirmer ce qui est activé dans votre instance avant de rédiger les supports de formation.
C'est également à cette étape que vous pourriez découvrir que votre contexte organisationnel nécessite certaines solutions de contournement ou des configurations personnalisées. Aucun déploiement en entreprise n'est prêt à l'emploi. En avoir conscience dès le départ et s'en servir pour collaborer étroitement avec l'équipe de mise en œuvre de votre fournisseur permet d'éviter que ces moments ne deviennent des surprises à grande échelle.
Phase 4 : Déploiement progressif par groupe
Déployer le système auprès de milliers d'utilisateurs simultanément est rarement une stratégie efficace. Une approche plus durable consiste en une mise en œuvre séquentielle : hiérarchisez les organisations, puis les groupes au sein de ces organisations, et enfin séquencez les groupes en fonction de critères de préparation.
Lors d'un déploiement majeur en entreprise que j'ai dirigé, nous avons classé les organisations selon la proportion de groupes de recherche détenant des échantillons réglementés, car le reporting réglementaire était le principal moteur de l'adoption institutionnelle. Au sein de chaque organisation, les groupes étaient classés selon l'état de leur inventaire d'échantillons en vue de la migration et leur disponibilité durant la période de déploiement.
Pour chaque groupe, le processus d'intégration suivait une structure cohérente: confirmation du périmètre, configuration des unités de stockage, migration des échantillons, formation des utilisateurs, mise en service et une période de support intensif avec un suivi étroit de l'adoption. Ce n'est qu'ensuite que les groupes passaient au support opérationnel standard.
Ce modèle permettait d'intégrer environ 60 utilisateurs par mois, ce qu'une équipe de deux personnes peut gérer durablement. Si votre équipe est plus nombreuse, vous pouvez monter en charge. Mais la structure reste la même.
Ce dont les chercheurs ont besoin pour adopter le système
Lors d'un déploiement, nous avions émis 290 licences, mais ne comptions que 170 utilisateurs actifs. Nous avions formé 175 utilisateurs sur la même période. La corrélation était évidente.
La formation ne doit pas seulement couvrir le fonctionnement général du logiciel, mais la manière dont votre organisation l'a configuré. Avec SciSure, l'interface s'ajuste dynamiquement en fonction des modules sous licence et des autorisations liées à votre rôle. Un chercheur et un administrateur de groupe au sein d'une même équipe verront les mêmes modules, mais auront accès à des menus, des boutons et des actions totalement différents. Tous deux verront également une interface différente de celle d'un administrateur organisationnel gérant le stockage et les accès pour plusieurs groupes.

La documentation générique du fournisseur ne couvrira pas ces spécificités. Il s'agit de documentation interne, et quelqu'un doit la rédiger, la maintenir et la rendre accessible.
Si vous implémentez un système sans matériel de formation interne et que la personne qui l'a conçu s'en va, le savoir part avec elle.
La formation lève le premier obstacle à l'adoption. Le second concerne les dysfonctionnements : les chercheurs et les administrateurs ont besoin d'un moyen structuré pour signaler les problèmes sans que tout n'atterrisse dans la boîte de réception d'une seule personne. Là où l'infrastructure informatique le permet (instance ServiceNow, Jira Service Management ou équivalent), il est judicieux de mettre en place rapidement une file d'attente de support dédiée au système.
Une file d'attente bien configurée ne se contente pas d'enregistrer les tickets. Elle facilite le tri, achemine les problèmes vers le bon interlocuteur et crée un historique consultable ce qui réduit les manipulations répétitives. Cela s'avère particulièrement précieux lors d'une escalade auprès d'un fournisseur, où un chemin de reproduction documenté et un numéro de référence peuvent accélérer la résolution et garantir la traçabilité.
Lorsque les chercheurs adoptent le système et le trouvent réellement utile, le bouche-à-oreille fonctionne. Les échantillons apparaissent. Les expériences sont consignées. D'autres groupes demandent quand viendra leur tour. Un système bien mis en œuvre se vend de lui-même en interne, mais seulement si les premiers utilisateurs ont une expérience suffisamment positive pour en parler.
Pour examiner de plus près à quoi ressemble réellement cette courbe d'adoption dans la pratique, notre guide sur la mise en œuvre d'un ELN dans un laboratoire existant traite le sujet en détail.
Ce que les dirigeants doivent comprendre avant de signer
L'argumentaire commercial en faveur d'un logiciel de gestion de laboratoire se concentre généralement sur le gain de temps et la conformité. Ces deux aspects sont réels. Mais l'argumentaire doit également aborder honnêtement les coûts de mise en œuvre, incluant non seulement les frais de licence, mais le coût total d'une équipe de projet dédiée, des ressources informatiques, de l'élaboration de la formation et d'une période prolongée de support intensif.
Les dirigeants qui approuvent le logiciel sans approuver l'infrastructure de mise en œuvre condamnent le projet à l'échec.
Le système devient un outil supplémentaire auquel les chercheurs ont techniquement accès, mais qu'ils ne jugent pas fiable, qu'ils n'utilisent pas et qu'ils finissent par contourner avec des feuilles de calcul.
Un déploiement bien exécuté vous offre une visibilité en temps réel sur votre inventaire d'échantillons réglementés et sur l'ensemble de vos opérations de recherche documentées via l'ELN et les flux de travail de protocoles de SciSure. La différence entre un déploiement qui tient ses promesses et un autre qui échoue réside rarement dans le logiciel lui-même. Elle tient à l'investissement organisationnel consenti pour assurer sa réussite.
Que vous soyez au début de ce projet, en plein déploiement et sous pression, ou en phase de transition vers le mode opérationnel, les questions essentielles à se poser concernent la responsabilité: qui décide, qui assure le support, qui gère les escalades, qui produit les rapports et qui veille à ce que les standards ne s'effritent pas une fois l'équipe de mise en œuvre partie.
Documentez ces réponses avant le lancement. SciSure est conçue pour évoluer, et avec une gouvernance adaptée, votre organisation le sera tout autant.
Read more of our blogs about modern lab management
Discover the latest in lab operations, from sample management to AI innovations, designed to enhance efficiency and drive scientific breakthroughs.