KI im Forschungslabor implementieren: 10 Schritte (2026)
Ein praktischer Leitfaden für Wissenschaftler, Laborleiter und IT-Teams zur Integration von KI in Forschungsprozesse im Jahr 2026.

Download Whitepaper
TL;DR
Um KI in einem Forschungslabor zu implementieren, beginnen Sie mit einer klaren Forschungsfrage, stellen Sie sicher, dass Ihre Daten strukturiert und nachvollziehbar sind, validieren Sie jedes Modell oder jeden Assistenten anhand bekannter Ergebnisse und gewähren Sie KI-Tools einen kontrollierten, berechtigungsbasierten Zugriff auf Laboraufzeichnungen.
- Beginnen Sie mit dem Problem.
Definieren Sie die Entscheidung oder den Engpass, bei dem die KI helfen soll, wie etwa bei der Bildanalyse, der Literaturrecherche oder dem Auffinden früherer Experimente. Eine präzise Fragestellung erleichtert die Auswahl eines Tools, die Messung der Genauigkeit und die Beurteilung des Erfolgs. Die meisten Labore beginnen heute mit bestehenden Tools, anstatt eigene Modelle zu entwickeln – prüfen Sie daher zuerst, was bereits verfügbar ist.
- Daten stehen an erster Stelle.
KI-Ergebnisse sind nur so gut wie die zugrunde liegenden Aufzeichnungen. Strukturierte Experimentprotokolle, konsistente Proben-Metadaten und eine klare Nachvollziehbarkeit machen Labordaten für Modelle und Assistenten nutzbar. Ein elektronisches Laborbuch (ELN) und ein Labor-Informations-Management-System (LIMS) wie SciSure ELN/LIMS erfassen diese Struktur direkt während der Arbeit.
- Validieren und kontinuierlich prüfen.
Testen Sie KI-Ergebnisse anhand von Daten mit bekannten Antworten, bevor Sie sich auf sie verlassen, und achten Sie anschließend auf Abweichungen. Regulierungsbehörden erwarten dieselbe Disziplin: Die FDA und die EMA haben im Januar 2026 zehn gemeinsame Prinzipien für KI in der Arzneimittelentwicklung veröffentlicht, die den Nutzungskontext, die Datenverwaltung und das Lebenszyklusmanagement abdecken.
- Kontrollierter Zugriff auf Labordaten.
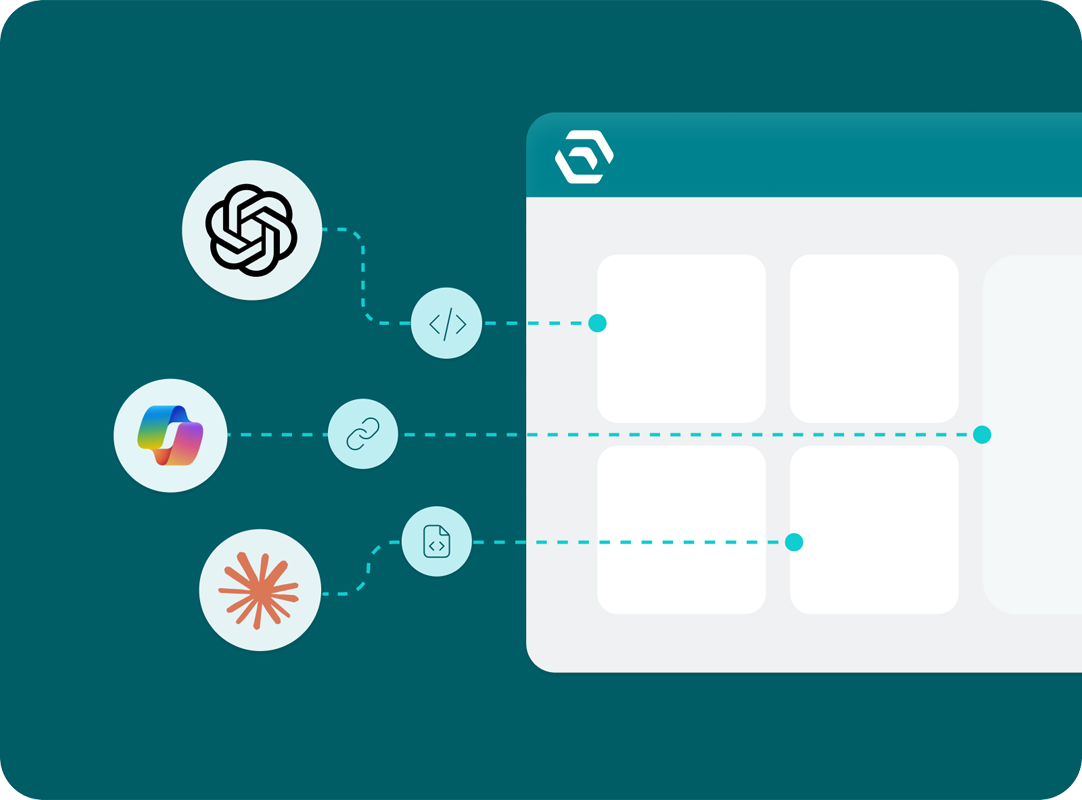
Die Verbindung von Assistenten wie Claude oder ChatGPT mit Laboraufzeichnungen darf niemals Berechtigungen umgehen. SciSure MCP bietet kompatiblen KI-Umgebungen einen schreibgeschützten Zugriff auf autorisierte Experimente, Proben und Protokolle in SciSure Research, wobei die bestehenden Zugriffsrechte jedes Benutzers gewahrt bleiben. Es läuft auf Private-Cloud- und On-Premise-Installationen.
Wir haben diesen Beitrag erstmals 2023 veröffentlicht und 2026 aktualisiert. Er enthält Umfragedaten von Forschenden von Wiley und Elsevier, aktuelle FDA- und EMA-Leitlinien zu KI, neue Definitionen für große Sprachmodelle, KI-Agenten und das Model Context Protocol sowie die aktuellen KI-Tools von SciSure für Forschungslabore.
Ready to see SciSure in action?
No commitment · Free consultation
Als wir diesen Leitfaden 2023 erstmals veröffentlichten, stellten sich die meisten Labore die Frage, ob KI überhaupt in die Forschung gehört. Im Jahr 2026 lautet die Frage, wie man sie sinnvoll einsetzt. Forschende nutzen bereits täglich allgemeine Assistenten, und Labore benötigen nun Tools, die mit ihren eigenen Experimenten, Proben und Protokollen arbeiten können, ohne die Kontrolle über die Daten zu verlieren.
Dieser Leitfaden führt Sie durch zehn praktische Schritte zur Implementierung von KI in einem Forschungslabor – von der Auswahl des richtigen Problems bis hin zur Validierung der Ergebnisse und der Anbindung von KI-Tools an Ihre Laboraufzeichnungen. Dabei zeigen wir auf, wo ein strukturiertes elektronisches Laborbuch (ELN) und Labor-Informations-Management-System (LIMS) wie SciSure hineinpassen und wo das Urteilsvermögen Ihres Teams nach wie vor am wichtigsten ist.
Jenseits der Schlagworte: Einige Definitionen
- Künstliche Intelligenz (KI)
Software, die Aufgaben ausführt, für die normalerweise menschliches Urteilsvermögen erforderlich ist, wie etwa das Erkennen von Mustern, das Treffen von Vorhersagen oder das Verstehen von Sprache.
- Maschinelles Lernen (ML)
Ein Teilbereich der KI, bei dem Modelle Muster aus Daten lernen, anstatt festen Regeln zu folgen. Wird im Labor für Klassifizierung, Vorhersagen und Anomalieerkennung eingesetzt.
- Deep Learning
Ein Teilbereich des ML, der mehrschichtige neuronale Netze verwendet. Er bildet die Grundlage für die moderne Bildanalyse, die Vorhersage von Proteinstrukturen und Sprachmodelle.
- Neuronales Netz
Ein Modell aus Schichten miteinander verbundener Knoten, das lose dem menschlichen Gehirn nachempfunden ist und komplexe Zusammenhänge in Daten erlernt.
- Big Data
Datensätze, die zu umfangreich oder zu vielfältig sind, um sie mit Tabellenkalkulationen oder manuellen Methoden zu verwalten, wie etwa Sequenzierungsläufe, High-Content-Imaging oder jahrelange Versuchsaufzeichnungen.
- Großes Sprachmodell (LLM) (neu)
Ein Deep-Learning-Modell, das mit riesigen Textmengen trainiert wurde und Fragen beantworten, Texte zusammenfassen und entwerfen kann. ChatGPT, Claude und Copilot basieren auf LLMs.
- KI-Agent (neu)
Ein KI-System, das Schritte zur Erreichung eines Ziels unternehmen kann – wie etwa Datensätze durchsuchen, Tools aufrufen und Ergebnisse kombinieren –, anstatt nur auf eine einzelne Eingabeaufforderung zu reagieren.
- Model Context Protocol (MCP) (neu)
Ein offener Standard zur Anbindung von KI-Anwendungen an externe Systemewie Datenbanken und Unternehmenssoftware. Er ermöglicht es einem Assistenten wie Claude oder ChatGPT, Informationen aus einem verbundenen System auf konsistente und kontrollierte Weise abzurufen.
Der Stand der KI in Forschungslaboren im Jahr 2026
KI hat sich vom Experiment zum alltäglichen Werkzeug entwickelt, doch Vertrauen und Governance konnten mit dieser Entwicklung nicht Schritt halten. Im Jahr 2024 wurde der Nobelpreis für Chemie ging teilweise an das AlphaFold2-Team, dessen Modell die Strukturen von nahezu allen der rund 200 Millionen von Forschern identifizierten Proteinen vorhersagte. Die meisten Labore nutzen KI jedoch auf weitaus gewöhnlichere Weise.
Aktuelle Umfragen unter Forschern zeigen die Kluft zwischen Nutzung und Vertrauen:
- Die Nutzung ist sprunghaft angestiegen.
Im Bereich Wileys ExplanAItions 2025-Studie unter 2.430 Forschern ergab, dass die Nutzung von KI für einen Teil ihrer Arbeit von 57 % im Jahr 2024 auf 84 % im Jahr 2025 gestiegen ist. Die Mehrheit (70 %) verlässt sich auf frei verfügbare Allzweck-Tools.
- Auch die Bedenken nehmen zu.
Die Sorge vor Ungenauigkeiten und Halluzinationen stieg von 51 % auf 64 %, die Bedenken hinsichtlich Datenschutz und Sicherheit von 47 % auf 58 %. Nur 41 % gaben an, dass ihre Organisation angemessene Unterstützung bietet.
- Vertrauen ist die Bremse in der industriellen Forschung und Entwicklung.
Im Bereich Dem Bericht „Corporate Researcher of the Future“ von Elsevier zufolge hatten zwei Drittel der Unternehmensforscher KI für ihre Arbeit genutzt, aber nur 27 % bezeichneten KI-Tools als vertrauenswürdig. Die Befragten gaben an, dass transparente Quellenangaben (70 %) und der vertrauliche Umgang mit Eingabedaten (63 %) ihre Nutzung steigern würden.
Die im ursprünglichen Beitrag genannten technischen Risiken gelten weiterhin. Modelle können Voreingenommenheit aus ihren Trainingsdaten übernehmen, und ihre Vorhersagen können schwer zu interpretieren sein. Der Unterschied besteht heute darin, dass die größten praktischen Fragen die Datenqualität, die Zugriffskontrolle und die Validierung betreffen. Die folgenden zehn Schritte basieren auf diesen Fragen.
So implementieren Sie KI in Ihrem Forschungslabor: 10 Schritte
Egal, ob Sie ein eigenes Modell entwickeln oder einen kommerziellen Assistenten mit Ihren Labordaten verknüpfen, es gilt dieselbe Regel: KI ist nur so zuverlässig wie die Daten, die Validierung und die Governance, die sie umgeben. Binden Sie Kollegen aus der Bioinformatik und Datenwissenschaft frühzeitig ein und ziehen Sie IT- und Qualitätsteams hinzu, bevor ein Tool mit Labordaten in Berührung kommt.
Schritt 1: Identifizieren Sie das Problem oder die Fragestellung
Beginnen Sie mit einem spezifischen Engpass, nicht mit „Wir brauchen KI“. Eine klare Fragestellung zeigt Ihnen, welche Art von Tool Sie benötigen und wie Sie beurteilen, ob es funktioniert. Häufige Ausgangspunkte in Forschungslaboren:
Denken Sie daran, dass Partner-Add-ons von Drittanbietern entwickelt werden und möglicherweise eine separate Lizenzierung erfordern.
Schritt 2: Recherchieren Sie verfügbare Tools, bevor Sie eigene entwickeln
Für die meisten Laborfragen ist ein bestehendes Tool schneller und kostengünstiger als ein maßgeschneidertes Modell. Vergleichen Sie die Optionen hinsichtlich Genauigkeitsnachweisen, Benutzerfreundlichkeit, Support und Dokumentation. Stellen Sie dann die Fragen, die Forscher am meisten beschäftigen:
- Wohin fließen Ihre Daten und werden sie zum Training der Modelle des Anbieters verwendet?
- Gibt das Tool seine Quellen an, sodass die Ergebnisse überprüft werden können?
- Respektiert es Ihre bestehenden Benutzerberechtigungen?
- Funktioniert es mit Ihrem Hosting-Modell und Ihrer Laborsoftware?
Entwickeln Sie nur dann ein eigenes Modell, wenn kein vorhandenes Tool für Ihre Fragestellung oder Ihre Daten geeignet ist.
Schritt 3: Stellen Sie sicher, dass Ihre Daten bereit sind
Überprüfen Sie Qualität, Umfang, Struktur und mögliche Verzerrungen Ihrer Daten. KI-Tools haben Schwierigkeiten mit Notizen, die über Papiernotizbücher, Tabellenkalkulationen und freigegebene Laufwerke verstreut sind. Die FAIR-Prinzipien (Findable, Accessible, Interoperable, Reusable – auffindbar, zugänglich, interoperabel, wiederverwendbar) sind ein nützlicher Maßstab, da sie sich auf Daten konzentrieren, die sowohl von Maschinen als auch von Menschen gefunden und wiederverwendet werden können.
In der Praxis bedeutet das: konsistente Bezeichnungen, erforderliche Metadatenfelder, Probenherkunft sowie Verknüpfungen zwischen Experimenten und den verwendeten oder generierten Proben. Mit SciSure können Teams Experimentdokumentationen mithilfe von Vorlagen und Protokollen strukturieren sowie Probentypen mit Pflichtfeldern und Eltern-Kind-Beziehungen definieren mit Probenverwaltung. Genau diese Struktur macht Laboraufzeichnungen später für KI nutzbar.
Schritt 4: Definieren Sie den Nutzungskontext und planen Sie die Validierung
Halten Sie genau fest, wofür die KI-Ausgabe verwendet werden soll und was passiert, wenn sie fehlerhaft ist. Ein Tool, das Fachartikel zur Lektüre vorschlägt, birgt weniger Risiken als eines, das eine Go/No-Go-Entscheidung für eine chemische Verbindung beeinflusst.
Der Entwurf der FDA zur KI-gestützten regulatorischen Entscheidungsfindung legt einen risikobasierten Ansatz fest: Frage definieren, Nutzungskontext festlegen, Modellrisiko bewerten und anschließend planen, wie die Glaubwürdigkeit der Ergebnisse nachgewiesen werden kann. Die Leitlinie bezieht sich auf KI zur Unterstützung regulatorischer Entscheidungen, nicht auf die frühe Forschungsphase, und befindet sich noch im Entwurfsstadium. Dennoch ist dieselbe Logik ein solider Weg, um die Validierung für jedes KI-Tool im Labor zu planen.
Berücksichtigen Sie Ausreißer und Grenzfälle in Ihrem Testplan, da Modelle genau dort am ehesten versagen.
Schritt 5: Trainieren oder konfigurieren Sie Ihr KI-Tool
Wenn Sie ein Modell entwickeln, trainieren Sie es mit Ihren aufbereiteten Daten und stimmen Sie die Parameter so ab, dass Fehler bei unbekannten Daten minimiert werden. Wenn Sie ein bestehendes Tool verwenden, ist die Konfiguration ebenso wichtig. Richten Sie Prompts, Vorlagen und Einstellungen ein, die den Standards Ihres Labors entsprechen. Zum Beispiel kann SciSures KI-Protokoll-Generator es Teams ermöglichen, Tonfall, Struktur und Kreativität der generierten SOP-Entwürfe anzupassen.

Schritt 6: Testen und validieren Sie die Ergebnisse
Testen Sie das Modell mit Daten, mit denen es nicht trainiert wurde, und vergleichen Sie die Ergebnisse mit bereits bekannten Resultaten. Verfolgen Sie bei Vorhersagemodellen Genauigkeit, Präzision und Trefferquote und achten Sie auf Overfitting. Stellen Sie bei sprachbasierten Assistenten Fragen, die Sie selbst beantworten können, überprüfen Sie jede Quellenangabe und bestätigen Sie, dass die Antworten mit den zugrunde liegenden Aufzeichnungen übereinstimmen.
Binden Sie qualifiziertes Personal ein. Von KI erstellte Protokolle, Zusammenfassungen und Vorschläge sind Entwürfe, bis sie von jemandem mit der entsprechenden Fachkenntnis überprüft wurden.
Schritt 7: Integration von KI in Ihren Labor-Workflow mit kontrolliertem Zugriff
KI ist dann am nützlichsten, wenn sie mit Ihren eigenen Labordaten arbeiten kann, und am riskantesten, wenn dies ohne Kontrollmechanismen geschieht. Bevor Sie einen Assistenten anbinden, legen Sie fest, auf welche Daten er zugreifen darf, welche Aktionen er ausführen kann und wie der Zugriff authentifiziert wird.
Mit SciSure MCP können Labore kompatible KI-Umgebungen wie Claude, ChatGPT oder lokal gehostete Modelle mit SciSure Research verbinden. Der Zugriff erfolgt schreibgeschützt, jede Anfrage wird authentifiziert und die KI sieht nur das, was der angemeldete Benutzer ohnehin sehen darf. Wissenschaftler können Fragen stellen wie „Haben wir ein bestehendes Protokoll für diesen Assay?“, ohne Daten exportieren zu müssen. Ebenso können Sie KI-gestützte Analysen in Ihrem ELN protokollieren, einschließlich des verwendeten Tools und der Version, damit die Ergebnisse nachvollziehbar bleiben.
SciSure MCP ist verfügbar für Private-Cloud- und On-Premises-Installationen. Einrichtungsanleitungen finden Sie im SciSure Developer Hub.
Schritt 8: Überwachung der Leistung im Zeitverlauf
Die Leistung von Modellen kann nachlassen, wenn sich Ihre Daten, Methoden und Prioritäten ändern. Kommerzielle KI-Tools verändern sich zudem, wenn Anbieter ihre zugrunde liegenden Modelle aktualisieren. Legen Sie einen Zeitplan für Überprüfungen fest, verfolgen Sie wichtige Kennzahlen und führen Sie ein einfaches Protokoll über Probleme, damit Sie erkennen, wann ein Tool Ihre Anforderungen nicht mehr erfüllt.
Schritt 9: Aktualisieren, neu trainieren und neu validieren
Wenn die Leistung nachlässt oder sich Ihre Anforderungen ändern, trainieren Sie das Modell mit neuen Daten nach, passen Sie Parameter an oder wechseln Sie das Tool. Behandeln Sie jede wesentliche Änderung wie eine Methodenänderung: Validieren Sie das System neu, bevor Sie sich wieder auf die Ergebnisse verlassen, und dokumentieren Sie, was geändert wurde und warum.
Schritt 10: Governance und Compliance von Anfang an integrieren
Schützen Sie personenbezogene Daten und Patientendaten gemäß Vorschriften wie DSGVO und HIPAA und prüfen Sie, ob die KI Datensätze berührt, die unter 21 CFR Part 11 oder GxP-Anforderungen fallen. Legen Sie eine klare Laborrichtlinie fest, welche Daten in welche KI-Tools eingegeben werden dürfen. Die Dokumentation des SciSure AI Protocol Generators rät beispielsweise davon ab, sensible oder vertrauliche Informationen einzugeben, da dessen KI-Engine außerhalb der SciSure-Umgebung ausgeführt wird.
Für umfassendere Rahmenbedingungen haben die FDA und EMA im Januar 2026 zehn gemeinsame Guiding Principles of Good AI Practice in Drug Development veröffentlicht, die einen risikobasierten Ansatz, Daten-Governance und Lebenszyklusmanagement abdecken. Das freiwillige NIST AI Risk Management Framework und sein Generative AI Profile bieten praktische Orientierung für jede Organisation.
Software kann die regelkonforme KI-Nutzung durch Berechtigungen, Audit-Trails und kontrollierten Zugriff unterstützen, doch die Verantwortung für Validierung, SOPs, Schulung und Überwachung liegt weiterhin bei Ihrer Organisation.
Wo SciSure in Ihre KI-Pläne passt
SciSure unterstützt drei Stufen der KI-Bereitschaft in Forschungslaboren:
- Eine strukturierte Datengrundlage.
SciSure ELN und LIMS erfasst Experimente, Protokolle und Proben als verknüpfte, durchsuchbare Datensätze mit Audit-Trails, damit KI-Tools auf Basis verlässlicher Daten arbeiten können.
- Geregelter Zugriff für die KI-Tools Ihrer Wahl.
SciSure MCP verbindet kompatible Assistenten mit autorisierten SciSure Research-Daten – schreibgeschützt und innerhalb der bestehenden Benutzerberechtigungen.
- KI-Tools direkt im Arbeitsablauf.
Der SciSure Marketplace bietet KI-Add-ons für die Protokollerstellung, Bildanalyse und Literaturrecherche sowie APIs und Integrationen für individuelle Anforderungen.

IT-Teams, die KI-Verbindungen prüfen, finden Details zu Hosting, Sicherheit und Integration auf der Seite für IT-Profis.
KI ist heute fester Bestandteil der täglichen Forschungsarbeit. Labore, die echten Mehrwert daraus ziehen, beginnen jedoch bei den Grundlagen: einer klaren Fragestellung, strukturierten Daten, einer ehrlichen Validierung und einem geregelten Zugriff. Ob Sie ein eigenes Modell entwickeln oder einen kommerziellen Assistenten anbinden – diese Fundamente entscheiden darüber, ob Sie den Ergebnissen vertrauen können.
Häufig gestellte Fragen
Wie implementiert man KI in einem Forschungslabor?
Beginnen Sie mit einer spezifischen Fragestellung, prüfen Sie, ob ein vorhandenes Tool diese beantworten kann, und stellen Sie sicher, dass Ihre Daten ausreichend strukturiert sind. Validieren Sie das Tool anhand bekannter Ergebnisse, verknüpfen Sie es mit Laboraufzeichnungen unter kontrolliertem Zugriff und überwachen sowie revalidieren Sie es kontinuierlich.
Was benötigt ein Labor, bevor es KI einsetzen kann?
Ein Labor benötigt gut strukturierte, konsistent gekennzeichnete Daten, einen klaren Anwendungsfall, einen Validierungsplan sowie eine Richtlinie darüber, welche Daten in welche Tools einfließen dürfen. Binden Sie IT- und Qualitätsteams frühzeitig ein, insbesondere wenn KI mit regulierten oder vertraulichen Aufzeichnungen in Berührung kommt.
Wie integriert man KI in Laborsysteme?
Die meisten Integrationen nutzen APIs oder zunehmend das Model Context Protocol (MCP), einen offenen Standard zur Anbindung von KI-Anwendungen an externe Systeme. Unabhängig von der Methode sollte sich die KI als Benutzer authentifizieren und nur auf Daten zugreifen, die für diese Person freigegeben sind.
Können KI-Assistenten wie ChatGPT oder Claude sicher auf unsere ELN-Daten zugreifen?
Das ist möglich, wenn die Verbindung kontrolliert erfolgt. SciSure MCP gewährt kompatiblen KI-Umgebungen schreibgeschützten Zugriff auf zulässige SciSure-Forschungsinformationen, wendet die bestehenden Berechtigungen des jeweiligen Benutzers an und verändert keine Datensätze. Es ist für Private-Cloud- und On-Premises-Installationen verfügbar.
Ist der Einsatz von KI in Forschungslaboren reguliert?
Es gibt keine einheitliche KI-Regelung für Forschungslabore, aber die bestehenden Vorschriften zum Datenschutz und zur Dokumentation gelten weiterhin. Für die Arzneimittelentwicklung hat die FDA einen Entwurf für Leitlinien zur KI-Unterstützung bei regulatorischen Entscheidungen veröffentlicht; zudem haben FDA und EMA im Januar 2026 zehn gemeinsame Prinzipien für gute KI-Praxis (Good AI Practice) herausgegeben.
Wenn das nach der Unterstützung klingt, die Sie benötigen, nehmen Sie Kontakt mit uns auf. zeigen wir Ihnen gerne, wie die KI-Tools von SciSure so konzipiert sind, dass sie sich in Ihre Laborabläufe einfügen – und nicht umgekehrt.
Weiterlesen
- Intelligente KI, echter Mehrwert: Innovation ohne Kompromisse
- ChatGPT sinnvoll in der Laborarbeit einsetzen
- Die Rolle von menschenzentrierter KI in Biotech-Laboren
- Die 5 besten elektronischen Laborbücher (ELN) im Jahr 2026, bewertet nach Benutzerfreundlichkeit & ROI: Basierend auf echten Nutzerbewertungen
- Die beste Software für Probenmanagement und -nachverfolgung: 5 Plattformen für Forschungsgruppen und Unternehmen

Read more of our blogs about modern lab management
Discover the latest in lab operations, from sample management to AI innovations, designed to enhance efficiency and drive scientific breakthroughs.